AI 模型排行榜還能照單全收嗎?用一份 MiniMax 報告學會查最新 LLM
MIU 喔爸傳來的 MiniMax 模型評比,更新 10 月官方型錄,附七張圖、查證步驟,以及三款模型的價格與試用推薦。

MIU 喔爸傳來一份 AI 模型評比,裡面有分數、價格,還有推薦名單。可是資料停在兩個月前。模型更新這麼快,先把日期和型號核對好,再來挑我們真正用得上的工具。
圖 1|金老佛爺肖像參考的教學插畫示意,並非本人使用或測試各模型的紀錄。
先看報告寫於哪一天
這次的原始 MiniMax Agent 報告題為「AI 模型 × 功能 橫向評比」,頁面明寫資料截至 2026 年 8 月 22 日,比較 11 個模型、11 個功能軸。它適合當時的研究起點;拿來做 10 月的採購或安裝決定,就要先重查版本。
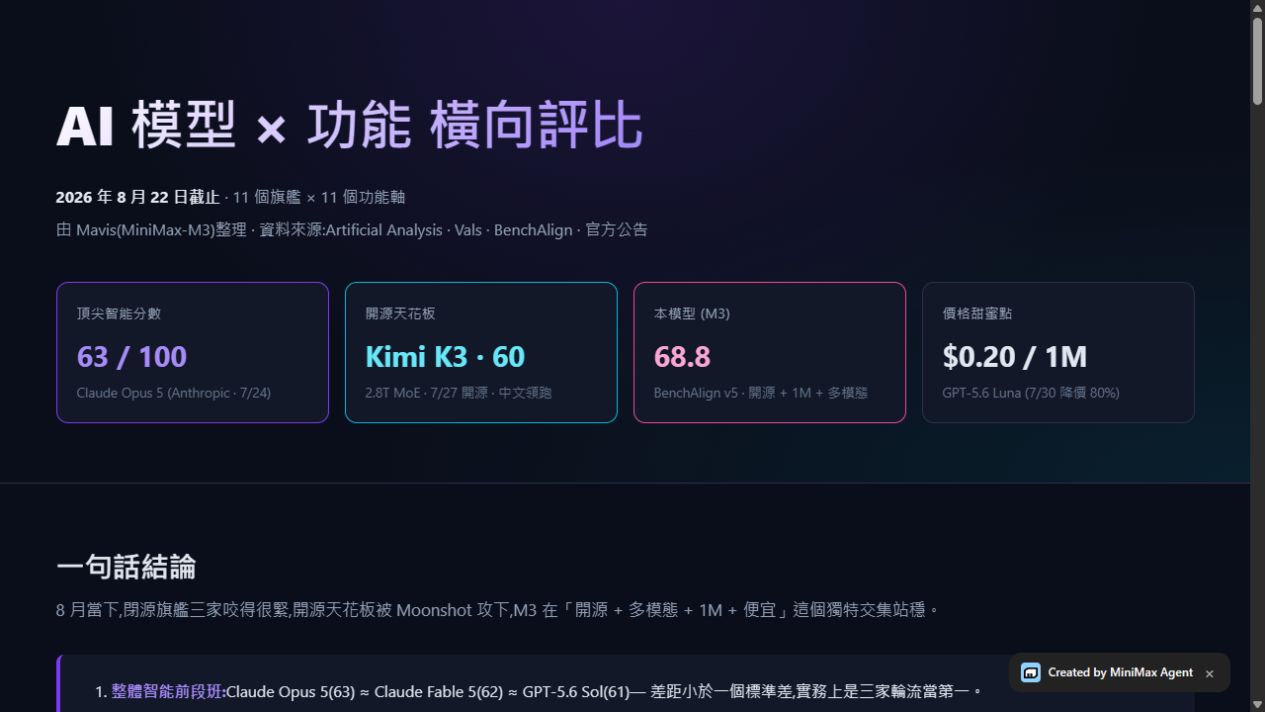
原表把不同榜單的分數、程式題、搜尋任務、價格和「開源」放在同一張表。讀起來很方便,但每一格若沒有原始測試連結、模型版本、測試日期與設定,就無法單憑表格宣布誰是現在的第一名。尤其原頁把 MiniMax M3 的不同榜單分數放在同一段敘述,數字的尺不一樣,不能直接平均。
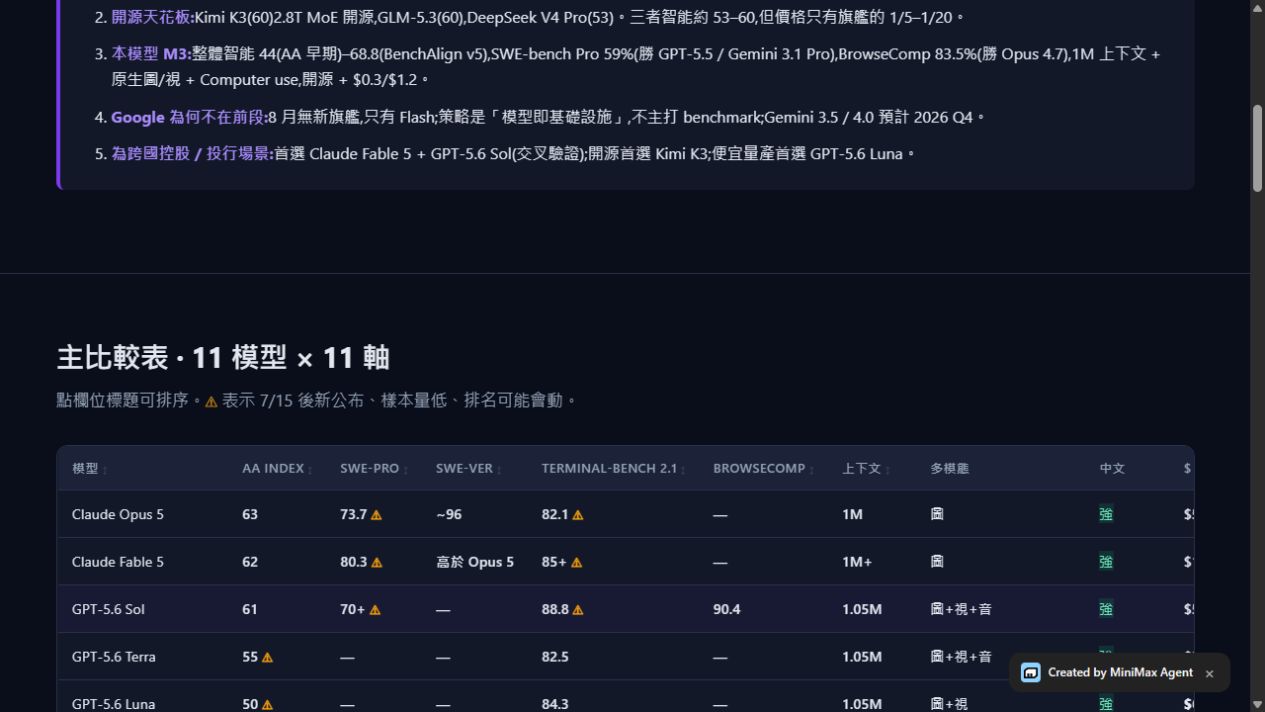
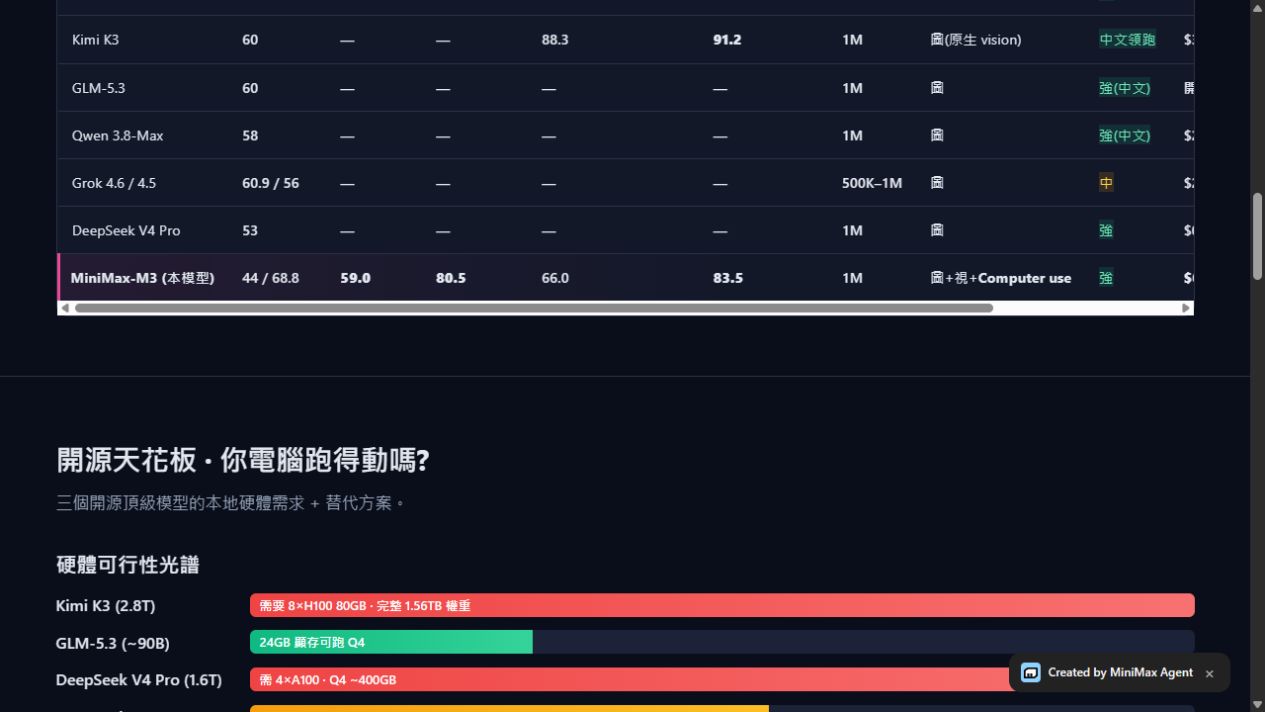
現在有哪些模型可以選?
以下按 2026 年 10 月 27 日各家官方型錄重查。下表是主要供應商的「查詢入口與代表型號」,不是全世界所有 LLM,也不是性能排行榜;同一公司還有研究版、區域版、預覽版與舊版。
| 公司/模型家族 | 今天可在官方頁面查到的代表型號 |
|---|---|
| OpenAI | GPT-6 Astra、GPT-6.1 Sol、GPT-6.1 Terra、GPT-6 Luna |
| Anthropic | Claude Fable 5.1、Opus 5.5、Sonnet 5.5、Haiku 5.5 |
| Gemini 4 Argon、Gemini 3.8 Flash | |
| xAI | Grok 4.7 |
| MiniMax | MiniMax M3.1 Flash、M3 |
| DeepSeek | DeepSeek V4.1 Flash、V4 Pro |
| Moonshot/Kimi | Kimi K3 |
| 阿里雲 Qwen | Qwen 3.8 Max |
| Z.ai GLM | GLM-5.3、GLM-5.3 Flash |
| Meta | Muse Wonder、Muse Spark 系列;Llama 4另有可取得權重的型號 |
| Mistral | Mistral Large 4、Small 4、Medium 3.5 |
| Cohere | Command 系列 |
MiniMax 的例子也提醒我們:「開源」不能只看一個標籤。M3.1 Flash 發布文寫明 API、M Plan、MiniMax Code 已可用,權重稍後發布;API 文件卻同時稱它是 open-weight。若你要自行下載部署,請先查到實際權重頁與授權條款,再決定。
三步把舊報告變成自己的選型清單
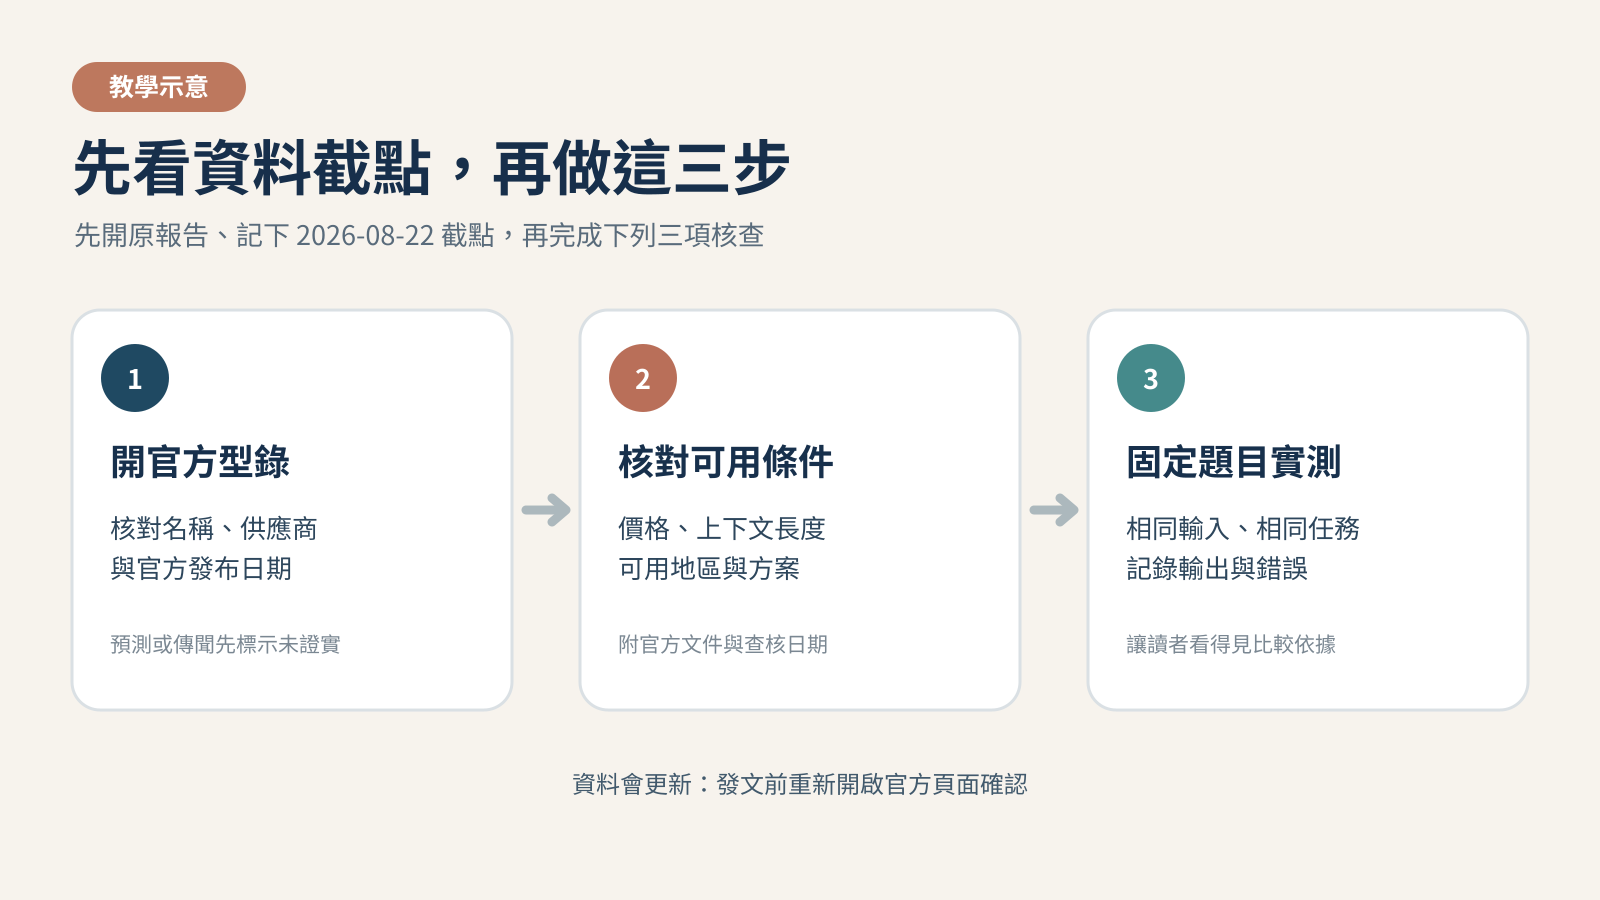
步驟 1:對版本。 點開上表的官方型錄,記下供應商、模型全名、型號 ID 和查核日期。看見「即將推出」與「預覽版」,不要直接填進「今天可用」欄。這次的明顯例子是原文預測 Gemini 4 會來,而 Google 官網現在已列 Gemini 4 Argon。
步驟 2:對條件。 想清楚你用的是網頁聊天產品、手機 App,還是 API。ChatGPT、Claude、Grok Bot、MiniMax Code、Codex 是產品或代理入口;GPT、Claude、Grok、MiniMax 的具體版本才是模型。入口能否搜尋、讀檔、操作電腦,也取決於方案、權限和工具設定,不能只看模型名稱。價格還要分 API、訂閱、地區、快取、尖峰時段與長文件費率,請在使用當天看各家官網。
步驟 3:拿自己的題目測。 用同一份可公開資料、同一段提示詞,至少測兩個你實際能用的候選。記下資料來源、錯誤、完成時間與需要自己修正的地方。沒有帳號或沒有實測,就寫「未測」,別替它填成績。
跟著做:用假活動資料試兩個模型
假設要為一場虛構的台韓生活講座整理公開資訊。複製下面提示詞到你已能使用的兩個聊天工具,貼上相同的活動資料;先把私人電話、未公開名單拿掉。
請只根據我貼上的活動資料,整理一份 150 字繁體中文摘要與「日期、地點、報名方式」三欄表。每一欄都指出原文位置;找不到就寫「原文未提供」。不要補造地址、價格或連結。最後列出兩個需要我人工確認的問題。
檢查時,不要只看哪篇文字漂亮:日期有沒有抄對?是否引用到你真的提供的資料?沒寫報名方式時會不會亂編? 把自己的觀察記在表格,再決定下一次用哪個工具。
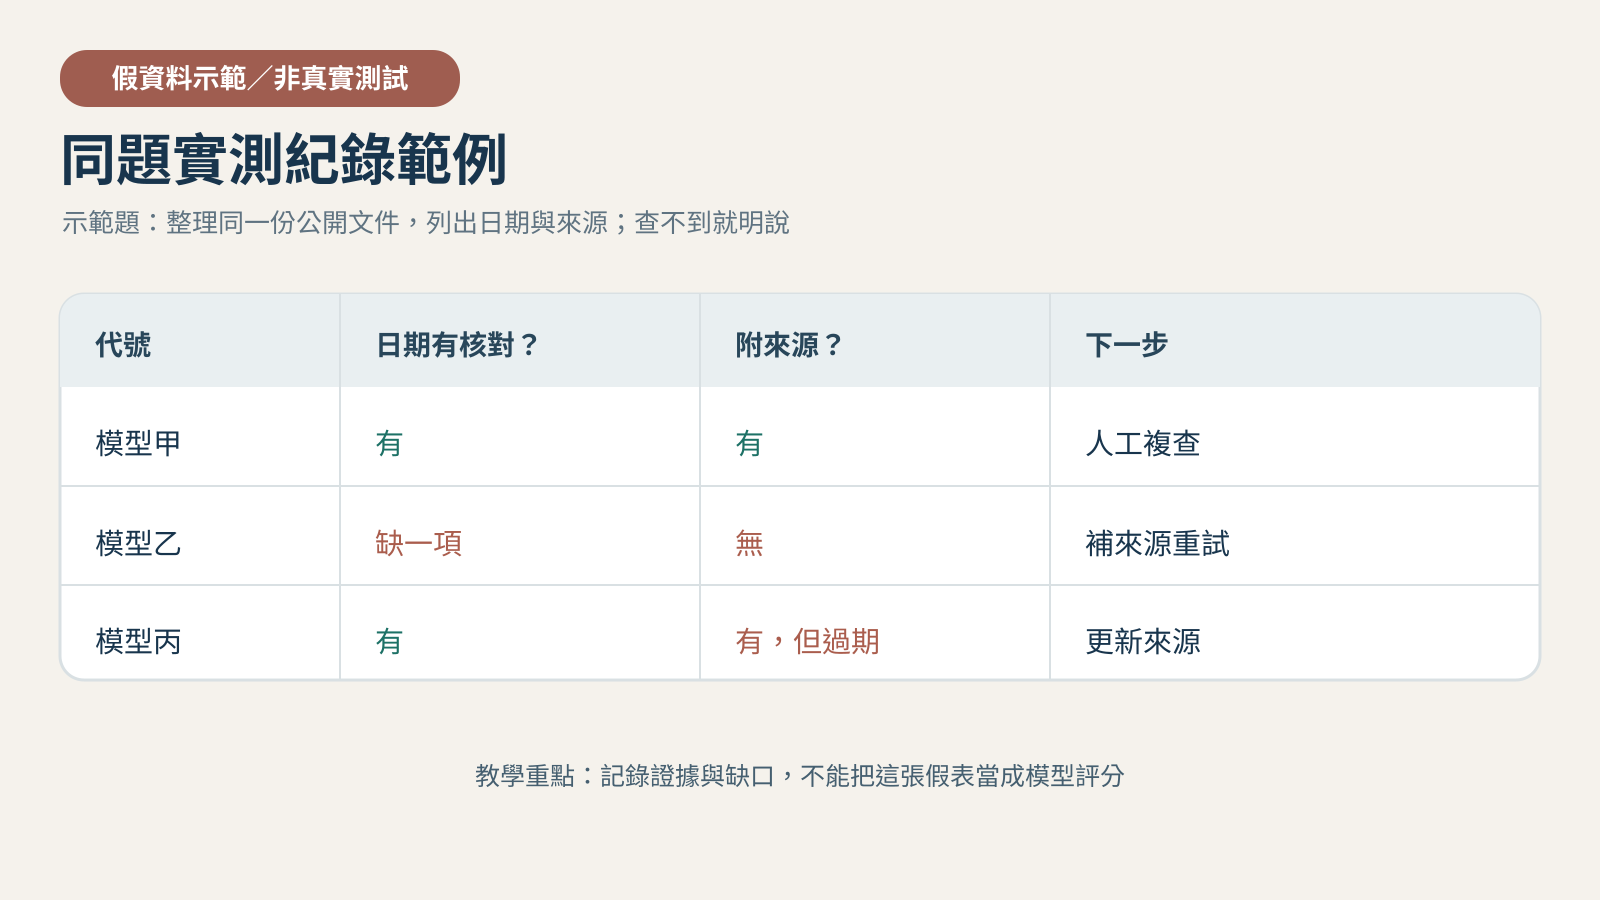
如果你要寫部落格,先選能附來源、可編修文字的工具;要改程式,才另外測代理能否修改檔案並通過驗證;要處理大量固定格式資料,再比較速度與費用。用自己的題目測過,下面的推薦順序也可以跟著調整。
金老佛爺推薦先試的前三個模型
如果是第一次挑模型,我會按「能幫忙整理資料和寫文章、價格看得懂、適合接著做同題測試」排這三個試用順序。這是依官方型錄與價格做的編輯推薦,尚未以同一題盲測所有模型,請不要當成全能排行榜。
| 順序與模型 | 官方 API 價格 | 推薦原因 |
|---|---|---|
| 1.GPT-6.1 Sol | 輸入 US$2/輸出 US$10 | 先拿來整理資料、列大綱和檢查文章缺口。OpenAI 把它列為能力與成本較平衡的選項,適合作為第一個比較基準。 |
| 2.Claude Sonnet 5.5 | 輸入 US$2/輸出 US$10 | 第二個測同一份長資料與初稿,看它的結構、語氣和引文是否更合你的需求。Anthropic 將它定位為速度與能力兼顧的型號。 |
| 3.MiniMax M3.1 Flash | 輸入 US$0.15/輸出 US$0.60 | 想反覆試提示詞、整理多份固定格式內容時,較低的 API 單價值得納入測試;還是要檢查漏項與錯誤。 |
價格單位都是每 100 萬個輸入/輸出 token,美元計價,查核於 2026-10-27;這是開發者 API 用量費,不是 ChatGPT、Claude 或 MiniMax 網頁版的月費。搜尋、工具、快取、地區與方案可能另外計價,付款前請再點官方價格頁確認。
金老佛爺的小提醒
看到「最新、最強、最便宜」先看日期,再看證據。AI 工具進步得快,今天有用的名單,下個月可能就要換。大家一起學習,帶著查證能力搭上科技急速改變的火箭吧!🚀✨
查核日期:2026-10-27。 本文的官方來源都已放在表格及段落連結,點開會另開新頁。本文未更改原 MiniMax Agent 報告;使用前請重開官方型錄確認版本、功能與費用。
Photo Album
讀者留言
載入中
目前沒有留言。